
L’expression “intelligence artificielle” ou “IA” est peut-être, de manière inévitable, devenue une sorte de mot à la mode. Ce terme est le plus souvent utilisé comme terme générique pour désigner un ensemble de processus et d’outils technologiques connexes, notamment l’apprentissage automatique, les réseaux neuronaux, l’IA générative et les grands modèles de langage.
Le présent guide reprend la définition de l’IA tirée du document intitulé Préparer l’écosystème de l’innovation à l’intelligence artificielle : Guide relatif aux politiques de propriété intellectuelle (OMPI, 2024) :
“L’intelligence artificielle désigne la branche de l’informatique et de l’ingénierie cherchant à créer des systèmes capables d’exécuter des tâches qui nécessitent généralement l’intelligence humaine. Parmi ces tâches figurent notamment la compréhension du langage naturel, la reconnaissance d’images, la prise de décisions et l’apprentissage à partir de données.”
Il est important de faire la distinction entre l’intelligence artificielle générale et l’intelligence artificielle spécifique (parfois appelée IA “étroite” ou “faible”). L’IA générale désigne un système d’IA capable d’égaler l’intelligence humaine dans tous les domaines, d’accomplir toute tâche pouvant être réalisée par un être humain et d’appliquer son raisonnement et sa capacité à résoudre des problèmes à des situations entièrement nouvelles, sans avoir besoin d’être entraîné. La plupart des chercheurs indépendants considèrent que l’IA générale reste pour l’instant un concept théorique. En revanche, une IA spécialisée est capable d’accomplir une tâche particulière ou un ensemble restreint de tâches avec un niveau de performance comparable à celui d’un être humain et, dans certains cas, elle surpasse systématiquement les experts humains dans certains domaines. L’IA spécifique est déjà une réalité et elle est largement utilisée pour des tâches spécialisées dans de nombreux domaines.
Même si l’IA générale n’est pas encore une réalité, l’IA spécifique remet déjà en question notre conception de l’IA en tant qu’acteur créatif, ce qui donne lieu à bon nombre des tensions en matière de propriété intellectuelle qui sont abordées dans ce guide. Traditionnellement, l’“IA” est considérée comme un outil utilisé par un être humain, qui reste l’auteur ou l’inventeur à l’origine du résultat obtenu. Si un être humain utilise un marteau pour fabriquer une table, on ne se demande pas si c’est le marteau qui a créé la table. Mais lorsqu’un système d’IA est capable de créer un roman, un composé pharmaceutique ou un morceau de musique avec un minimum d’intervention ou de directives humaines, il devient difficile de répondre à la question de savoir qui, ou quoi, en est l’auteur. C’est ce qui rend si complexe la question de la paternité des œuvres générées par l’IA et du droit d’auteur sur ces œuvres.
Qu’est-ce que l’apprentissage automatique?
Le terme “apprentissage automatique” a été inventé par l’informaticien Arthur Samuel en 1959. Il l’a définie comme un domaine d’étude qui permet aux ordinateurs d’apprendre de nouvelles choses par l’exemple et l’expérience, plutôt que d’être programmés de manière explicite. Bien que les techniques d’apprentissage automatique existent depuis plusieurs décennies, trois avancées majeures ont entraîné une véritable révolution dans ce domaine ces dernières années. Il s’agit :
de la croissance et la généralisation des immenses ensembles de données numériques, à savoir les “mégadonnées”;
des progrès sans précédent en matière de puissance de calcul; et
des progrès de l’informatique.
Les “mégadonnées” sont le principal moteur des progrès récents. Les processus d’apprentissage automatique s’appuient sur les données : plus il y a de données et meilleure est leur qualité, plus les systèmes et leurs résultats gagnent en précision. Par exemple, un individu, voire une équipe, pourrait ne pas être en mesure de donner un sens à des dizaines de millions d’enregistrements d’achats provenant d’une chaîne de magasins. Mais ces données peuvent être intégrées à un système informatique et, grâce à l’“apprentissage automatique”, servir à extrapoler les tendances des ventes, à générer des rapports sur les stocks, à détecter les vols et à automatiser certaines tâches. Plus le système aura accès à un grand nombre de données d’achat, plus ses résultats seront précis.
Autrefois, les programmes informatiques reposaient en grande partie sur du code écrit par un programmeur humain, qui prédéfinissait les caractéristiques du résultat recherché. Il s’agissait d’un processus long et imprécis, qui nécessitait une grande puissance de calcul. Mais aujourd’hui, les “mégadonnées”, associées à l’augmentation rapide de la puissance de calcul, ont entraîné une véritable évolution des algorithmes : les systèmes informatiques sont désormais capables d’apprendre et de s’améliorer à mesure qu’ils sont exposés à de nombreux exemples, et ne dépendent plus d’une définition a priori, établie par un programmeur, du résultat recherché.
Il convient toutefois de souligner ici que toutes les mégadonnées ne sont pas “égales”. L’utilisation de données biaisées et inexactes dans l’apprentissage automatique peut entraîner des résultats biaisés et erronés. Si un système d’apprentissage automatique est entraîné à partir de données obsolètes, peu fiables ou invérifiables (dans certains cas, afin de réduire les coûts), les résultats qu’il produira seront eux aussi peu fiables et obsolètes, et son utilisation dans certains domaines (tels que la médecine, les transports ou la finance) pourrait avoir des conséquences graves, voire fatales.
Qu’est-ce qu’un réseau neuronal?
En 2019, l’Institut Max Planck (MPI) pour l’innovation et la concurrence a mené une étude approfondie sur les aspects techniques de l’“IA” sous l’angle du droit de la propriété intellectuelle. Cette étude considère que le “modèle d’apprentissage automatique entraîné” (ci-après dénommé le “modèle”) constitue le fondement de ce que nous entendons par “IA”. Ces modèles reposent sur des fonctions mathématiques et génèrent des résultats en apprenant à reconnaître des tendances dans les données qui leur sont fournies.
Un réseau neuronal artificiel est un type spécifique de modèle entraîné qui s’inspire de la structure et du fonctionnement du cerveau humain pour extraire des modèles et des représentations à partir de données. Ces modèles s’inspirent de la logique connexionniste des neurosciences, selon laquelle les neurones, organisés en réseaux, établissent des associations en fonction de la force des connexions synaptiques. De même, les modèles de réseaux neuronaux sont constitués de nœuds, ou neurones (qui sont des fonctions mathématiques), reliés entre eux par des “poids” (qui représentent une valeur numérique). Les “réseaux neuronaux” profonds sont organisés en plusieurs couches grâce auxquelles ils peuvent traiter des données afin de produire des résultats non linéaires.
Pour créer un réseau neuronal artificiel, l’architecture doit être mise au point par un programmeur avant le début du processus d’apprentissage. Cette architecture est fixe et n’évolue pas au cours du processus d’apprentissage automatique; c’est pourquoi on l’appelle parfois “hyperparamètre”. Cependant, les poids reliant les neurones sont des paramètres adaptatifs ou “entraînables”, ce qui signifie qu’ils peuvent évoluer de manière autonome à mesure qu’ils apprennent à partir des données, plutôt que d’être préprogrammés.
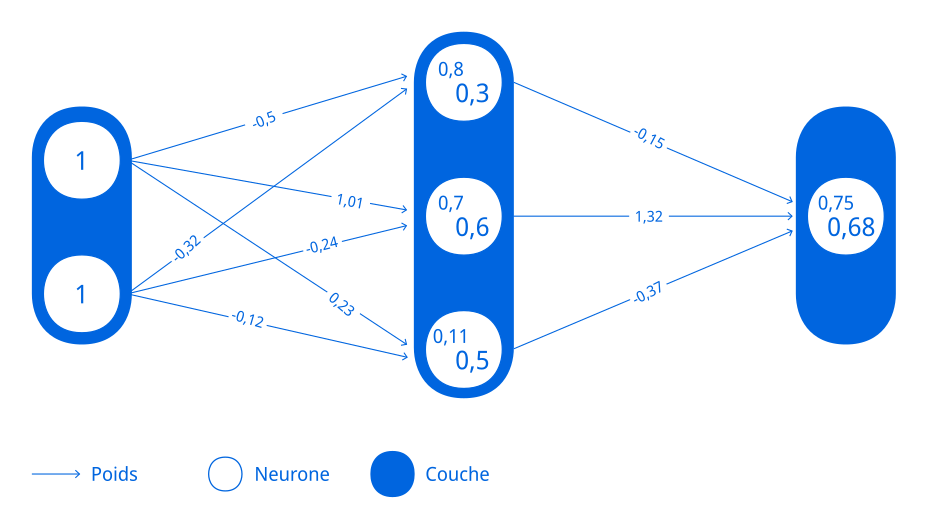 Source : Drexl, J. et al. (2019). “Technical Aspects of Artificial Intelligence: An Understanding from an Intellectual Property Law Perspective”.
Qu’est-ce que l’intelligence artificielle générative?
Le terme “IA générative” désigne les outils d’IA capables de générer du nouveau contenu à partir de la requête d’un utilisateur. Une requête est généralement une brève description écrite du résultat souhaité. Ces nouveaux contenus peuvent prendre la forme de textes, de code informatique, d’images, de fichiers audio, de sons et de vidéos.
La généralisation des outils d’IA générative a des implications importantes en matière de propriété intellectuelle dans de nombreux secteurs, ce qui présente à la fois des opportunités et des risques. Un aspect essentiel en matière de propriété intellectuelle est que les modèles d’IA générative ne se lancent pas d’eux-mêmes : ils doivent recevoir une requête d’un être humain, formulée d’une certaine manière, pour pouvoir générer un résultat. En effet, l’“ingénierie de requête” (le processus consistant à créer et à affiner les instructions d’entrée afin d’amener les modèles d’IA générative à produire de meilleurs résultats plus rapidement) s’est imposée comme une compétence à part entière qui nécessite une bonne compréhension des capacités et des limites d’un modèle d’IA.
Qu’est-ce qu’un grand modèle de langage?
Les grands modèles de langage (LLM) constituent un type de modèle de réseau neuronal. Les LLM sont à la base de nombreux outils d’IA générative populaires actuellement disponibles sur le marché. Ils portent ce nom car ils sont particulièrement adaptées au traitement et à la mise en corrélation du langage. Ils peuvent effectuer diverses tâches de traitement du langage naturel, notamment produire des textes, traduire, résumer des textes, répondre à des questions, etc.
Les LLM ne se limitent pas au traitement du langage humain. Dans le domaine de l’apprentissage automatique, le terme “langage” désigne tout système de symboles (tels que des mots ou du code) qui véhicule du sens par le biais de sa structure et des relations qu’il établit. Tout comme le langage humain tire son sens à la fois du choix des mots et des relations grammaticales, les langages de programmation suivent des schémas similaires en matière de syntaxe et de contexte. C’est pourquoi certains grands modèles de langage sont capables de générer du code informatique dans des langages de programmation courants tels que Python ou JavaScript. Afin de saisir efficacement ces relations complexes dans n’importe quelle langue, les LLM sont conçus pour traiter des séquences, gérer de grands ensembles de données et conserver une mémoire contextuelle suffisante.
Lancé en novembre 2022 par OpenAI, ChatGPT est l’agent conversationnel (chatbot) fondé sur un grand modèle de langage qui a propulsé l’IA au premier plan de la conscience collective, transformant rapidement la manière dont les professionnels de nombreux secteurs travaillent et créent. ChatGPT utilise le traitement du langage naturel et l’apprentissage profond pour générer du contenu écrit en réponse aux requêtes des utilisateurs. Bien qu’il ait été le premier du genre à s’imposer auprès du grand public, des concurrents tels qu’Anthropic, Google et Meta ont lancé des chatbots similaires peu de temps après.