
Термин «искусственный интеллект», или «ИИ», пожалуй, неизбежно стал своего рода модным словом. Чаще всего он используется в качестве обобщающего термина для обозначения совокупности связанных между собой технологических процессов и инструментов, включая машинное обучение, нейронные сети, генеративный ИИ (GenAI) и большие языковые модели.
В настоящем руководстве используется определение ИИ, приведенное в публикации «Адаптация инновационной экосистемы к ИИ. Пособие по разработке политики в области ИС» (ВОИС, 2024 год):
«Искусственный интеллект (ИИ) — это одно из направлений информатики и инженерии, цель которого заключается в создании систем, способных выполнять задачи, обычно требующие участия человеческого интеллекта. Это, в частности, понимание естественного языка, распознавание изображений, принятие решений и обучение на основе данных».
Важно различать общий искусственный интеллект (AGI) и специализированный искусственный интеллект (иногда называемый «узким» или «слабым» ИИ). AGI — это система ИИ, способная обладать интеллектом, сопоставимым с человеческим, во всех областях, выполнять любые задачи, которые способен выполнять человек, а также применять рассуждение и решать задачи в совершенно новых ситуациях без дополнительного обучения. В настоящее время большинство независимых исследователей считают AGI сугубо теоретической концепцией. Напротив, специализированный ИИ способен выполнять конкретную задачу или узкую группу задач на уровне, сопоставимом с человеческим, а в некоторых случаях даже стабильно превосходит человека в определенных областях. Специализированный ИИ уже существует и широко используется для решения конкретных задач во многих сферах.
Хотя AGI еще не существует, специализированный ИИ уже заставляет нас по-новому взглянуть на роль ИИ в творческой деятельности, что порождает многие из рассматриваемых в настоящем руководстве проблем в сфере ИС. Традиционно ИИ рассматривался как инструмент, которым управляет человек, остающийся автором или изобретателем созданного с его помощью результата. Если человек использует молоток, чтобы сделать стол, мы не задаемся вопросом, является ли молоток создателем этого стола. Но когда система ИИ способна создать роман, лекарство или музыкальное произведение при минимальном участии или руководстве человека, становится трудно ответить на вопрос, кто или что их создало. Именно это делает таким сложным вопрос об авторстве ИИ и авторских правах на созданные с помощью ИИ произведения.
Что такое машинное обучение
Термин «машинное обучение» был предложен специалистом в области информатики Артуром Сэмюэлом в 1959 году. Он определял машинное обучение как область исследований, которая дает компьютерам возможность учиться новому на основе примеров и опыта, а не посредством явного программирования. Хотя методы машинного обучения применяются уже многие десятилетия, в последние годы три крупных достижения привели к заметной революции в этой области. К ним относятся:
рост объема и широкая доступность огромных массивов цифровых данных, то есть «больших данных»,
беспрецедентный рост вычислительных мощностей и
достижения в области информатики.
Большие данные являются важнейшим фактором последних достижений в этой области. Процессы машинного обучения основаны на данных: чем больше данных и чем выше их качество, тем точнее становятся системы и результаты их работы. Например, человек или даже группа людей могут оказаться не в состоянии извлечь сколько-нибудь значимую информацию из десятков миллионов записей о покупках, накопленных розничной сетью. Однако эти данные можно загрузить в компьютерную систему и с помощью машинного обучения использовать для прогнозирования тенденций продаж, составления отчетов о запасах, выявления случаев кражи и автоматизации труда. Чем больше записей о покупках доступно системе, тем точнее будут ее результаты.
В прошлом в основе компьютерной программы лежал код, написанный программистом, который заранее определял характеристики искомого результата. Это был трудоемкий и неточный процесс, требовавший значительных вычислительных ресурсов. Однако сегодня большие данные в сочетании с быстрым ростом вычислительных мощностей привели к существенному изменению алгоритмов: вычислительные системы могут обучаться и совершенствоваться по мере обработки множества примеров и больше не зависят от заранее заданного программистом определения искомого результата.
Здесь следует сделать важное замечание: не все большие данные «одинаковы». Использование смещенных и неточных данных в машинном обучении может приводить к получению смещенных и ошибочных результатов. Если система машинного обучения обучается на устаревших, ненадежных или непроверяемых данных (в некоторых случаях в целях снижения затрат), результаты ее работы также будут ненадежными и устаревшими, а использование такой системы в определенных областях (например, в медицине, на транспорте или в сфере финансов) может иметь тяжелые и даже фатальные последствия.
Что такое нейронная сеть
В 2019 году Институт инноваций и конкуренции им. Макса Планка (MPI) провел комплексное исследование технических аспектов ИИ с точки зрения права ИС. В этом исследовании «модель машинного обучения, прошедшая обучение» (сокращенно — «модель»), определяется как основа того, что мы понимаем под «ИИ». Эти модели основаны на математических функциях и генерируют результаты посредством выявления закономерностей в данных, на которых они обучаются.
Искусственная нейронная сеть представляет собой особый тип обученной модели, созданной по образцу структуры и принципов функционирования человеческого мозга и способной выявлять закономерности и формировать представления на основе данных. Эти модели следуют коннекционистской логике нейробиологии, согласно которой нейроны, организованные в сети, устанавливают ассоциации в зависимости от силы синаптической связи. Аналогичным образом, модели нейронных сетей состоят из узлов, или нейронов (которые представляют собой математические функции), соединенных «весами» (которые представляют собой числовые значения). «Глубокие» нейронные сети состоят из множества слоев, через которые они обрабатывают данные для получения нелинейных результатов.
Для создания искусственной нейронной сети до начала процесса обучения программист должен разработать ее архитектуру. Эта архитектура является фиксированной и не изменяется в процессе машинного обучения, поэтому ее иногда называют «гиперпараметром». Однако веса, связывающие нейроны, являются адаптируемыми или «обучаемыми» параметрами, т. е. они могут самостоятельно изменяться по мере обучения на данных, а не являются заранее запрограммированными.
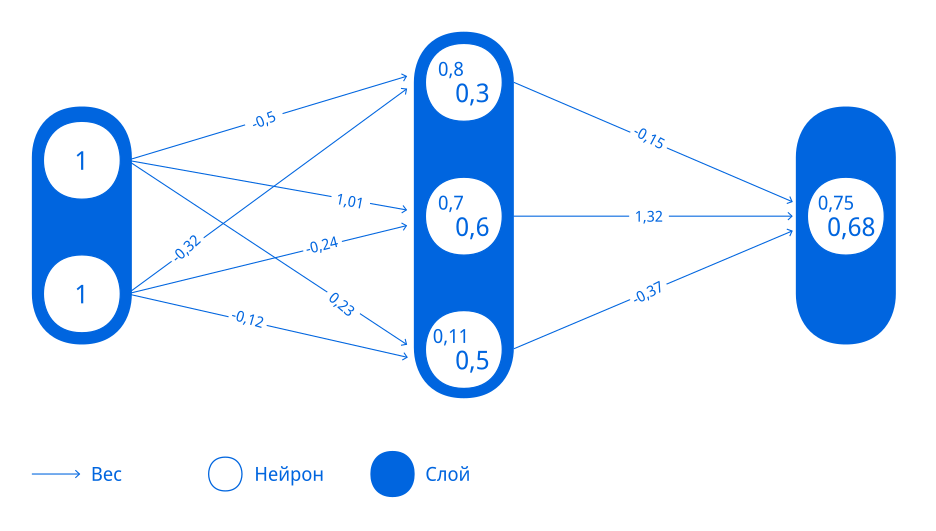 Источник: Drexl, J. et al.(2019). "Technical Aspects of Artificial Intelligence: An Understanding from an Intellectual Property Law Perspective".
Что такое генеративный ИИ
Генеративный ИИ — это ИИ-инструменты, способные создавать новый контент на основе запроса пользователя. Запрос, как правило, представляет собой краткое письменное описание желаемого результата. Новый контент может включать текст, компьютерный код, изображения, аудиозаписи, звуковые эффекты и видео.
Широкая доступность инструментов генеративного ИИ имеет существенные последствия для ИС во многих отраслях, создавая как возможности, так и риски. Что особенно важно с точки зрения ИС, модели генеративного ИИ не запускаются самостоятельно: для получения результата им необходимо определенное задание, сформулированное человеком. Действительно, «инжиниринг промптов» (процесс создания и совершенствования вводных инструкций с целью получения более быстрых и качественных результатов от моделей генеративного ИИ) стал отдельным навыком, требующим понимания возможностей и ограничений модели ИИ.
Что такое большая языковая модель
Большие языковые модели (LLM) представляют собой разновидность нейронных сетей. Именно LLM лежат в основе многих популярных инструментов генеративного ИИ, доступных сегодня на открытом рынке. Они получили такое название, поскольку отлично подходят для обработки и сопоставления языковых данных. LLM способны выполнять различные задачи обработки естественного языка, включая генерацию текста, перевод, обобщение текста и многое другое.
LLM не ограничиваются обработкой человеческого языка. В терминологии машинного обучения под «языком» понимается любая система символов (таких как слова или код), передающая смысл посредством структуры и взаимосвязей. Подобно тому, как человеческий язык извлекает смысл как из выбора слов, так и из грамматических отношений, языки программирования следуют аналогичным моделям синтаксиса и контекста. Именно поэтому некоторые LLM способны генерировать компьютерный код на распространенных языках программирования, таких как Python или JavaScript. Чтобы эффективно охватывать эти сложные взаимосвязи в текстах на любом языке, LLM создаются таким образом, чтобы обрабатывать последовательности, работать с большими массивами данных и сохранять достаточный объем контекстной памяти.
В ноябре 2022 года компания OpenAI представила чат-бот на основе LLM под названием ChatGPT, после чего ИИ стал широко обсуждаться в обществе, быстро изменив то, как люди во многих сферах работают и создают новое. ChatGPT использует обработку естественного языка и глубокое машинное обучение для генерации письменного контента в ответ на промпты пользователей. Хотя он стал первой подобной моделью, получившей широкое распространение, вскоре аналогичные чат-боты выпустили конкуренты, такие как Anthropic, Google и Meta.