
El término “inteligencia artificial” o “IA” se ha convertido, quizá de forma inevitable, en una especie de palabra de moda. Se utiliza con mucha frecuencia como término genérico que hace referencia a un conjunto de procesos y herramientas tecnológicas conectados entre sí, entre los que figuran el aprendizaje automático, las redes neuronales, la IA generativa y los grandes modelos de lenguaje.
La presente guía adopta la definición de IA de la publicación Preparar el sistema de innovación para la IA: guía de políticas de PI (OMPI, 2024):
”La inteligencia artificial (IA) es la rama de la informática y de la ingeniería que se centra en la creación de sistemas que puedan realizar tareas para las que normalmente se requiere la inteligencia humana. Entre estas tareas se incluyen la comprensión del lenguaje natural, el reconocimiento de imágenes, la adopción de decisiones y el aprendizaje a partir de datos.”
Es importante distinguir entre inteligencia artificial general e inteligencia artificial específica (denominada a veces IA "limitada" o "débil"). Por inteligencia artificial general se entiende un sistema de IA capaz de igualar el nivel de inteligencia humana en todos los ámbitos, de realizar cualquier tarea que pudiera llevar a cabo el ser humano y de aplicar el razonamiento y la resolución de problemas a situaciones totalmente nuevas sin necesidad de entrenamiento. La mayoría de los investigadores independientes consideran que la IA general es, por ahora, una cuestión teórica. En cambio, la IA específica puede realizar una tarea concreta o un conjunto limitado de tareas con un nivel de calidad similar al de un ser humano y, en algunos casos, supera de forma sistemática a los expertos humanos en determinados ámbitos. La IA específica ya está entre nosotros y se utiliza ampliamente para tareas especializadas en muchos campos.
Aunque la IA general aún no es una realidad, la IA específica sigue planteando desafíos en cuanto a nuestra forma de concebir la IA como agente creativo, lo que da lugar a muchos de las cuestiones conflictivas en materia de PI que se analizan en la presente guía. Desde siempre, la IA se ha entendido como una herramienta manejada por un ser humano, que sigue siendo el autor o inventor de los resultados obtenidos. Si una persona utiliza un martillo para construir una mesa, no nos preguntamos si el martillo es el creador de la mesa. Pero cuando un sistema de IA es capaz de crear una novela, un compuesto farmacológico o una pieza musical con una intervención o dirección humana mínima, resulta difícil responder a la pregunta de quién o qué lo ha creado. Por eso resulta tan compleja la cuestión de la calidad de inventor y los derechos de autor sobre las obras generadas por la IA.
¿Qué es el aprendizaje automático?
El término “aprendizaje automático” fue acuñado por el informático Arthur Samuel en 1959. Samuel lo definió como el campo de estudio que dota a las computadoras de la capacidad de aprender cosas nuevas mediante ejemplos y experiencias, en lugar de ser programadas de forma explícita. Aunque las técnicas de aprendizaje automático llevan existiendo desde muchos decenios, tres grandes avances han propiciado una revolución notable en este ámbito en los últimos años. Son los siguientes:
el creciente volumen y la amplia disponibilidad de conjuntos masivos de datos digitales, es decir, los macrodatos;
los avances sin precedentes en la potencia de cálculo; y
los avances en informática.
Los macrodatos son el principal factor que ha contribuido a los avances recientes. Los procesos de aprendizaje automático se nutren de datos: cuantos más datos haya y mejor sea su calidad, mayor será la precisión de los sistemas y de sus resultados. Por ejemplo, es posible que una persona, o incluso un equipo de personas, no sea capaz de extraer mucha información útil de decenas de millones de registros de compras de una red de tiendas. Sin embargo, esos datos pueden introducirse en una computadora y, mediante el aprendizaje automático, utilizarse para extrapolar patrones de ventas, elaborar informes de existencias, detectar robos y automatizar tareas. Cuantos más registros de compras tenga el sistema a su disposición, más precisos serán sus resultados.
En el pasado, los programas informáticos dependían en gran medida del código creado por un programador humano, que predefinía las características del resultado deseado. Se trataba de un proceso largo e impreciso, que requería una gran potencia de cálculo. Ahora, sin embargo, los macrodatos, junto con el aumento acelerado de la potencia de cálculo, han dado lugar a un auténtico avance en los algoritmos: los sistemas computacionales pueden aprender y mejorar a medida que se les presentan numerosos ejemplos y ya no dependen de que un programador defina a priori el resultado deseado.
Una consideración importante a este respecto es que no todos los macrodatos se consideran “iguales”. El uso de datos sesgados e inexactos en el aprendizaje automático puede dar lugar a resultados sesgados y erróneos. Si un sistema de aprendizaje automático se entrena a partir de datos obsoletos, poco fiables o no comprobables (en algunos casos, para minimizar los costos), los resultados que genere también serán poco fiables y obsoletos, y su aplicación en determinados ámbitos (como la medicina, el transporte o las finanzas) podría acarrear consecuencias graves e incluso fatales.
¿Qué es una red neuronal?
En 2019, el Instituto Max Planck (MPI) para la Innovación y la Competencia llevó a cabo un estudio exhaustivo sobre los aspectos técnicos de la IA desde la perspectiva del derecho de la PI. En el estudio se señala que el “modelo de aprendizaje automático entrenado” (en adelante, el “modelo”) es un elemento fundamental de lo que entendemos por “IA”. Estos modelos se basan en funciones matemáticas y producen resultados mediante el proceso de aprendizaje de las pautas o patrones presentes en los datos a los que se les exponen.
Las redes neuronales artificiales son tipos concretos de modelos entrenados que se inspiran en la estructura y el funcionamiento del cerebro humano para adquirir patrones y representaciones a partir de datos. Estos modelos siguen la lógica conexionista de la neurociencia, según la cual las neuronas, organizadas en redes, establecen asociaciones en función de la intensidad de la conexión sináptica. Del mismo modo, los modelos de redes neuronales están formados por nodos o neuronas (que son funciones matemáticas) conectados mediante “pesos” (que representan un valor numérico). Las redes neuronales “profundas” están organizadas en numerosas capas mediante las cuales pueden procesar datos para generar resultados no lineales.
Para crear una red neuronal artificial, un programador debe diseñar la arquitectura antes de iniciar todo el proceso de entrenamiento. Esta arquitectura es fija y no cambia durante el proceso de aprendizaje automático, por lo que a veces se denomina “hiperparámetro”. Sin embargo, los pesos que conectan las neuronas son parámetros adaptables o “entrenables”, lo que significa que pueden transformarse de forma autónoma a medida que aprenden de los datos, en lugar de estar preprogramados.
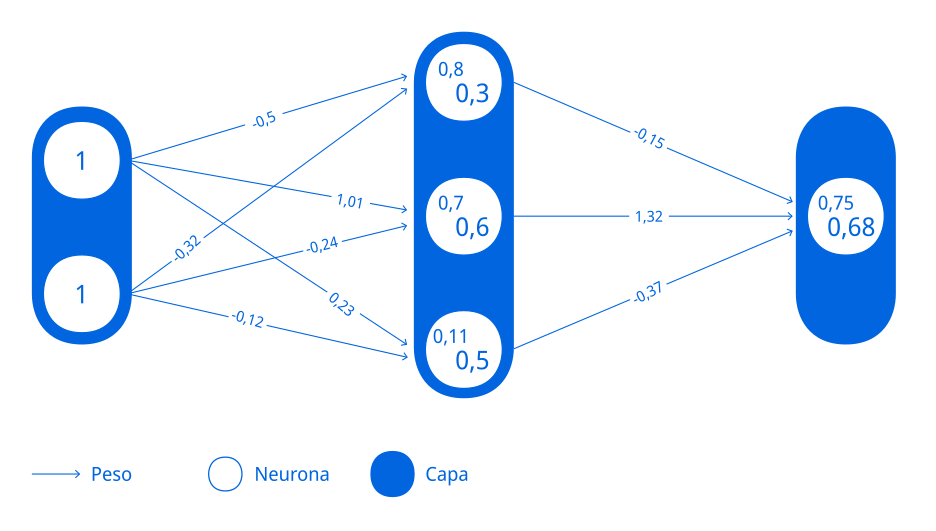 Fuente: Drexl, J. y otros (2019)."Technical Aspects of Artificial Intelligence: An Understanding from an Intellectual Property Law Perspective".
¿Qué es la IA generativa?
El término “IA generativa” hace referencia a las herramientas de IA capaces de generar contenido nuevo a partir de las instrucciones del usuario. Una instrucción o indicación (prompt) es normalmente una breve descripción escrita del resultado deseado. El nuevo contenido puede presentarse en forma de texto, código informático, imágenes, audio, sonido y video.
El hecho de que las herramientas de IA generativa estén disponibles de manera generalizada tiene importantes repercusiones en materia de PI en numerosos sectores, y conlleva oportunidades y riesgos a la vez. Un aspecto fundamental a efectos de la PI es que los modelos de IA generativa no se ponen en marcha por sí solos: deben recibir una indicación de un ser humano de una forma determinada para poder generar un resultado. De hecho, la “ingeniería de indicaciones” (el proceso de crear y perfeccionar las instrucciones de entrada para que los modelos de IA generativa produzcan mejores resultados con mayor rapidez) se ha consolidado como una competencia específica que exige comprender las capacidades y limitaciones de los modelos de IA.
¿Qué son los grandes modelos de lenguaje?
Los grandes modelos de lenguaje (LMM) son un tipo de modelo de red neuronal. Los grandes modelos de lenguaje alimentan muchas de las herramientas de IA generativa más populares disponibles actualmente en el mercado. Se denominan así porque son muy adecuados para procesar el lenguaje y establecer correlaciones. Asimismo, pueden realizar diversas tareas de procesamiento del lenguaje natural, como crear textos, traducirlos, resumirlos, etcétera.
Los LLM no se limitan a procesar el lenguaje humano. En el ámbito del aprendizaje automático, el término “lenguaje” hace referencia a los sistemas de símbolos (como palabras o código) que transmiten significado en función de su estructura y relaciones. Del mismo modo en que el lenguaje humano adquiere significado a partir de la elección de las palabras y mediante los vínculos gramaticales, los lenguajes de programación aplican patrones similares de sintaxis y contexto. Por eso algunos grandes modelos de lenguaje pueden producir código informático en lenguajes de programación corrientes como Python o JavaScript. Con el fin de reflejar eficazmente estas relaciones complejas en cualquier tipo de lenguaje, los grandes modelos de lenguaje están diseñados para procesar secuencias, manejar grandes conjuntos de datos y mantener una memoria contextual suficientemente amplia.
ChatGPT, puesto en marcha en noviembre de 2022 por OpenAI, fue el chatbot basado en un LLM que situó la IA en el punto de mira de la opinión pública, transformando rápidamente la forma de trabajar y de crear de las personas en muchos ámbitos. ChatGPT utiliza el procesamiento del lenguaje natural y el aprendizaje automático profundo para crear contenido escrito en respuesta a las instrucciones de los usuarios. Aunque fue el primero de su clase en lograr una adopción generalizada, poco después la competencia, como Anthropic, Google y Meta, puso en marcha chatbots similares.