
ربما أصبح مصطلح "الذكاء الاصطناعي" أو "AI" مصطلحًا شائعًا بشكل لا مفر منه. وغالبًا ما يُستخدم كمصطلح شامل للإشارة إلى مجموعة من العمليات والأدوات التكنولوجية ذات الصلة، بما في ذلك التعلم الآلي، الشبكات العصبية، و الذكاء الاصطناعي التوليدي (GenAI) ، و نماذج اللغة الكبيرة.
يتبنى هذا الدليل تعريف الذكاء الاصطناعي الوارد في "إعداد منظومة الابتكار لاستقبال الذكاء الاصطناعي: مجموعة أدوات لسياسات الملكية الفكرية" (المنظمة العالمية للملكية الفكرية، 2024):
يشير الذكاء الاصطناعي (AI) إلى فرع علوم وهندسة الحاسوب الذي يركز على إنشاء أنظمة قادرة على أداء المهام التي تتطلب عادةً ذكاءً بشرياً. وتشمل هذه المهام فهم اللغة الطبيعية والتعرف على الصور واتخاذ القرارات والتعلم من البيانات.
من المهم التمييز بين الذكاء الاصطناعي العام (AGI)، و الذكاء الاصطناعي المحدد (الذي يُطلق عليه أحيانًا اسم الذكاء الاصطناعي "الضيق" أو "الضعيف"). يشير مصطلح "الذكاء الاصطناعي العام" (AGI) إلى نظام ذكاء اصطناعي قادر على مضاهاة مستوى الذكاء البشري في جميع المجالات، وأداء أي مهمة يمكن للإنسان القيام بها، وتطبيق الاستدلال وحل المشكلات في مواقف جديدة تمامًا دون الحاجة إلى تدريب. ويرى معظم الباحثين المستقلين أن الذكاء الاصطناعي العام AGI لا يزال نظريًا في الوقت الحالي. وعلى النقيض من ذلك، يمكن للذكاء الاصطناعي المخصص أداء مهمة معينة أو مجموعة محدودة من المهام بمستوى مماثل لما يمكن للإنسان تحقيقه، بل إنه يتفوق في بعض الحالات باستمرار على الخبراء البشريين في مجالات معينة. الذكاء الاصطناعي المحدد موجود بالفعل ويُستخدم على نطاق واسع في المهام المتخصصة في العديد من المجالات.
وعلى النقيض من ذلك، يمكن للذكاء الاصطناعي المحدد أداء مهمة معينة أو مجموعة محدودة من المهام بمستوى مماثل لما يمكن للإنسان القيام به، وفي بعض الحالات يتفوق باستمرار على الخبراء البشريين في مجالات معينة. تقليديًّا، كان يُنظر إلى الذكاء الاصطناعي على أنه أداة يشغلها الإنسان، الذي يظل هو المؤلف أو المخترع وراء الناتج. تقليديًا، يُفهم الذكاء الاصطناعي على أنه أداة يشغلها الإنسان، الذي يظل هو المؤلف أو المخترع وراء الناتج. ولكن عندما يتمكن نظام الذكاء الاصطناعي من إنتاج رواية أو مركب دوائي أو مقطوعة موسيقية دون الحاجة إلى تدخل أو توجيه بشري يذكر، يصبح من الصعب الإجابة عن السؤال المتعلق بمن أو ما الذي ابتكرها. وهذا ما يجعل مسألة ملكية الاختراع وحقوق النشر في الأعمال التي ينتجها الذكاء الاصطناعي معقدة للغاية.
ما هو التعلم الآلي؟
صاغ عالم الحاسوب آرثر صامويل مصطلح "التعلم الآلي" في عام 1959. وقد عرّفه بأنه مجال دراسي يمنح الحواسيب القدرة على تعلم أشياء جديدة من خلال الأمثلة والتجارب، بدلاً من البرمجة الصريحة. ورغم أن تقنيات التعلم الآلي موجودة منذ عدة عقود، إلا أن ثلاثة تطورات كبيرة أحدثت ثورة ملحوظة في هذا المجال خلال السنوات الأخيرة. وتتمثل في:
نمو مجموعات البيانات الرقمية الضخمة وتوافرها على نطاق واسع، أي "البيانات الضخمة"؛
القفزات غير المسبوقة في قوة الحوسبة؛ و
التقدم في علوم الحاسوب.
تعد البيانات الضخمة أكبر مساهم في التطورات الحديثة. تعتمد عمليات التعلم الآلي على البيانات: فكلما زادت كمية البيانات وتحسنت جودتها، زادت دقة الأنظمة ونتائجها. على سبيل المثال، قد لا يتمكن الإنسان، أو حتى فريق من البشر، من استخلاص معنى كبير من عشرات الملايين من سجلات الشراء الخاصة بسلسلة متاجر التجزئة. لكن يمكن إدخال هذه البيانات في نظام حاسوبي، ومن خلال التعلم الآلي، استخدامها لاستقراء اتجاهات المبيعات، وإنشاء تقارير المخزون، وكشف السرقات، وأتمتة العمل. وكلما زاد عدد سجلات الشراء التي يمكن للنظام الوصول إليها، زادت دقة مخرجاته.
في الماضي، كانت برامج الكمبيوتر تعتمد بشكل كبير على الأكواد التي ينتجها مبرمج بشري، الذي كان يحدد مسبقًا ملامح النتيجة المرجوة. وكانت هذه عملية تستغرق وقتًا طويلاً وغير دقيقة، وتتطلب قدرًا كبيرًا من قوة الحوسبة. ولكن الآن، أدت البيانات الضخمة، إلى جانب الزيادات السريعة في قوة الحوسبة، إلى تحول حقيقي في الخوارزميات: فقد أصبحت الأنظمة الحاسوبية قادرة على التعلم والتحسين مع تعرضها للعديد من الأمثلة، ولم تعد تعتمد على التعريف المسبق للنتيجة المرجوة من قِبل المبرمج.
ومن المهم هنا التنبيه إلى أن البيانات الضخمة ليست كلها "متساوية". يمكن أن يؤدي استخدام البيانات المتحيزة وغير الدقيقة في التعلم الآلي إلى مخرجات متحيزة وخاطئة. إذا تم تدريب نظام التعلم الآلي على بيانات قديمة أو غير موثوقة أو لا يمكن التحقق منها (في بعض الحالات، لتقليل التكاليف)، فإن النتائج التي ينتجها ستكون أيضًا غير موثوقة وقديمة، وقد يؤدي تطبيقها في مجالات معينة (مثل الطب أو النقل أو التمويل) إلى عواقب وخيمة بل ومميتة.
ما هي الشبكة العصبية؟
في عام 2019، أجرى معهد ماكس بلانك (MPI) للابتكار والمنافسة دراسة شاملة للجوانب التقنية للذكاء الاصطناعي من منظور قانون الملكية الفكرية. تحدد الدراسة "نموذج التعلم الآلي المدرب" (باختصار، "النموذج") باعتباره أساسًا لما نفهمه على أنه "الذكاء الاصطناعي". تستند هذه النماذج إلى دوال رياضية وتولد مخرجات من خلال عملية تعلم الأنماط في البيانات التي تتعرض لها.
والشبكة العصبية الاصطناعية هي نوع محدد من النماذج المدربة التي تستلهم من بنية الدماغ البشري وطريقة عمله لاكتساب الأنماط والتمثيلات من البيانات. وتتبع هذه النماذج المنطق التواصلي لعلم الأعصاب، حيث تُنشئ الخلايا العصبية المنظمة في شبكات ارتباطات وفقًا لقوة الارتباط بين المشابك العصبية. وبالمثل، تتكون نماذج الشبكات العصبية من عقد، أو خلايا عصبية (وهي دوال رياضية) متصلة بواسطة "أوزان" (تمثل قيمة عددية). يتم ترتيب الشبكات العصبية "العميقة" في طبقات عديدة يمكنها من خلالها معالجة البيانات لإنتاج مخرجات غير خطية.
لإنشاء شبكة عصبية اصطناعية، يجب على المبرمج تطوير البنية قبل بدء عملية التدريب بأكملها. هذه البنية ثابتة ولا تتطور خلال عملية التعلم الآلي، ولذلك تُسمى أحيانًا "المعلمة الفائقة". ومع ذلك، فإن الأوزان التي تربط الخلايا العصبية هي معلمات قابلة للتكيف أو "قابلة للتدريب"، مما يعني أنها يمكن أن تتطور بشكل مستقل أثناء تعلمها من البيانات، بدلاً من أن تكون مبرمجة مسبقًا.
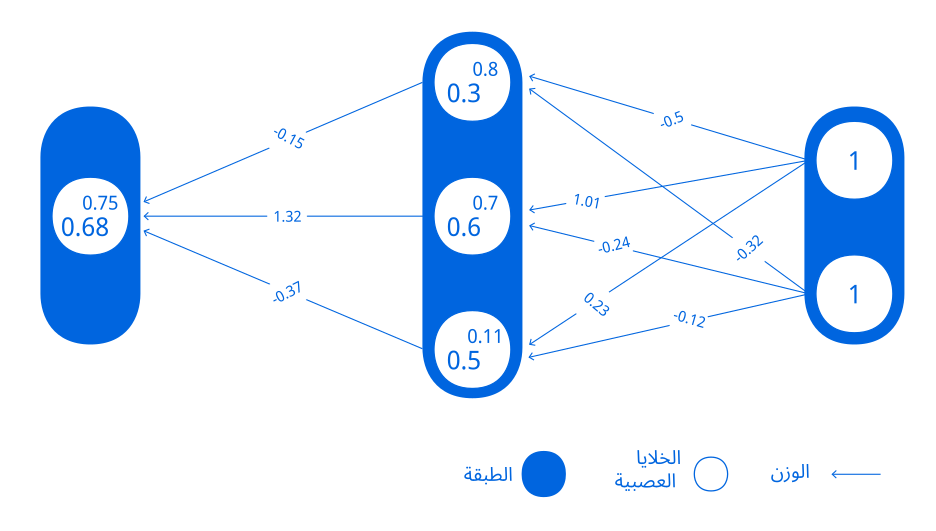 المصدر: دريكسل، ج. وآخرون(2019). "الجوانب التقنية للذكاء الاصطناعي: فهم من منظور قانون الملكية الفكرية".
ما هو الذكاء الاصطناعي التوليدي؟
يشير مصطلح الذكاء الاصطناعي التوليدي (GenAI) إلى أدوات الذكاء الاصطناعي القادرة على توليد محتوى جديد بناءً على موجه من المستخدم. وعادةً ما يكون الموجه وصفًا مكتوبًا قصيرًا للنتيجة المرجوة. ويمكن أن يتخذ المحتوى الجديد شكل نص أو كود حاسوبي أو صور أو مقاطع صوتية أو مقاطع فيديو.
إن التوافر الواسع النطاق لأدوات الذكاء الاصطناعي التوليدي (GenAI) له آثار كبيرة على الملكية الفكرية في العديد من الصناعات، مما يوفر فرصًا ومخاطر في آن واحد. ومن الناحية الجوهرية فيما يتعلق بالملكية الفكرية، لا تعمل نماذج الذكاء الاصطناعي العام (GenAI) من تلقاء نفسها: بل يجب أن يتولى الإنسان توجيهها بطريقة معينة حتى تتمكن من إنتاج مخرجات. وبالفعل، برزت "هندسة التوجيهات" (عملية إنشاء وصقل تعليمات الإدخال لجعل نماذج الذكاء الاصطناعي التوليدي تنتج مخرجات أفضل بسرعة أكبر) كميزة متميزة تتطلب فهمًا لقدرات نموذج الذكاء الاصطناعي وقيوده.
ما هو نموذج اللغة الكبير؟
نماذج اللغة الكبيرة (LMMs) هي نوع من نماذج الشبكات العصبية. تعمل نماذج اللغة الكبيرة (LLMs) على تشغيل العديد من أدوات الذكاء الاصطناعي العام (GenAI) الشائعة المتوفرة في السوق المفتوحة اليوم. وقد سُميت بهذا الاسم لأنها مناسبة تمامًا لمعالجة اللغة وربطها. يمكن لنماذج اللغة الكبيرة (LLMs) أداء مهام متنوعة لمعالجة اللغة الطبيعية، بما في ذلك توليد النصوص، وترجمة اللغات، وتلخيص النصوص، وغير ذلك.
لا تقتصر نماذج اللغة الكبيرة على معالجة اللغة البشرية. في مصطلحات التعلم الآلي، تشير "اللغة" إلى أي نظام من الرموز (مثل الكلمات أو الأكواد) التي تنقل المعنى من خلال البنية والعلاقات. وكما تستمد اللغة البشرية معناها من اختيار الكلمات والعلاقات النحوية على حد سواء، تتبع لغات البرمجة أنماطًا مشابهة في الصياغة والسياق. ولهذا السبب، يمكن لبعض نماذج اللغة الكبيرة (LLMs) إنشاء أكواد برمجية بلغات البرمجة الشائعة مثل بايثون أو جافا سكريبت. وللتعرف بفعالية على هذه العلاقات المعقدة عبر أي نوع من أنواع اللغات، صُممت نماذج اللغات الكبيرة (LLMs) لمعالجة التسلسلات، والتعامل مع مجموعات البيانات الضخمة، والحفاظ على ذاكرة سياقية كافية.
أطلقت شركة OpenAI برنامج ChatGPT في نوفمبر 2022، وهو روبوت الدردشة القائم على نماذج اللغة الكبيرة (LLM) الذي وضع الذكاء الاصطناعي في صدارة اهتمامات الجمهور، وأحدث تغييرًا سريعًا في طريقة عمل الناس وإبداعاتهم في العديد من المجالات. يستخدم ChatGPT معالجة اللغة الطبيعية والتعلم الآلي العميق لتوليد محتوى مكتوب استجابةً لمطالبات المستخدم. ورغم أنه كان الأول من نوعه الذي حقق انتشارًا واسعًا، إلا أن منافسين مثل Anthropic وGoogle وMeta أطلقوا روبوتات دردشة مماثلة بعد ذلك بوقت قصير.