
“人工智能”(AI)一词或许已不可避免地成为一个流行热词。它最常被用作一个统称,指代一系列相关的技术流程和工具,包括机器学习、神经网络、生成式人工智能(GenAI),以及大型语言模型。
本指南采用《帮助创新生态系统做好准备迎接人工智能:知识产权政策工具包》(产权组织,2024年)中对AI的定义:
“人工智能(AI)是计算机科学和工程的一个分支,专注于创建能够执行通常需要人类智力的任务的系统。这些任务包括理解自然语言、识别图像、做出决策和从数据中学习。”
区分通用人工智能(AGI)与专用人工智能(有时也被称为“窄人工智能”或“弱人工智能”)非常重要。通用人工智能指的是一种能够在所有领域达到与人类相当的智能水平,执行人类能够完成的任何任务,并在未经过训练的情况下,将推理和问题解决能力应用于全新情境中的AI系统。大多数独立研究人员目前认为通用人工智能仍处于理论阶段。相比之下,专用人工智能能够以与人类相当的水准完成某项特定任务或一组范围有限的任务,并且在某些情况下,能在特定领域中持续超越人类专家的表现。专用人工智能已经实现,并在诸多领域中被广泛用于执行专项任务。
尽管通用人工智能尚未实现,但专用人工智能仍对我们将AI视为创作主体的认知构成挑战,从而引发了本指南中探讨的许多知识产权争议。传统上,AI一直被视为一种由人类操作的工具,而人类始终是其输出背后的创作者或发明者。如果一个人用一把锤子造了一张桌子,我们不会问锤子是不是桌子的创造者。但当一个AI系统只需极少的人工输入或指导,就能生成一部小说、一种药物化合物或一段音乐,关于“谁”或“什么”创造了它的这个问题,就变得难以回答了。这正是使AI发明权以及AI生成作品的版权问题变得如此复杂的原因。
什么是机器学习?
“机器学习”一词是由计算机科学家亚瑟·塞缪尔(Arthur Samuel)于1959年提出的。他将“机器学习”定义为一种使计算机无需显式编程即可从示例和经验来学习新知识的研究方向。虽然机器学习技术已经存在了几十年,但近年来,三大重要进展给这一领域带来了显著的变革。分别是:
海量数字数据集(即“大数据”)的增长及其广泛可用性;
算力实现了前所未有的飞跃;以及
计算机科学的进步。
大数据是近期取得进展的最大推动力。机器学习过程依赖于数据:数据越多、数据质量越高,系统及其输出结果就越准确。例如,一个人,甚至是一支团队,可能无法从某零售连锁店的数千万条购买记录中得出多少有意义的结论。但这些数据可以输入到计算机系统中,并通过机器学习,用于推测销售趋势、生成库存报告、检测盗窃行为以及实现劳动力自动化。系统可访问的采购记录越多,其输出结果就越准确。
过去,计算机程序在很大程度上依赖于人类程序员编写的代码,程序员会预先定义所寻求结果的各项特征。这是一个既费时又不精确的过程,需要大量的算力。但如今,大数据与算力的飞速提升相结合,已促使算法发生了真正的转变:计算系统能够通过接触大量示例来学习和改进,不再依赖程序员对所寻求结果的先验定义。
这里需要特别注意的是,并非所有大数据都“平等”地产生。在机器学习中使用存在偏差和不准确的数据,可能会导致输出出现偏差和错误。如果机器学习系统基于过时、不可靠或无法验证的数据进行训练(在某些情况下,这么做是为了降低成本),那么其生成的结果也将不可靠且过时,而在特定领域(如医疗、交通或金融)应用这些结果可能会导致严重甚至致命的后果。
什么是神经网络?
2019年,马克斯·普朗克创新与竞争研究所从知识产权法的角度出发,对AI的技术层面进行了全面研究。该研究将“经过训练的机器学习模型”(以下简称“模型”)明确为我们所理解的“AI”的基础。这些模型基于数学函数构建,通过学习所接触数据中的模式来生成输出。
人工神经网络是一种经过训练的特定模型,它借鉴人脑的结构与运行机制,从数据中获得模式和表征。这些模型遵循神经科学的联结主义逻辑,即组织成网络的神经元会根据突触连接的强度建立关联。同样,神经网络模型由节点(即神经元,是数学函数)构成,这些节点通过“权重”(代表数值)相互连接。“深度”神经网络排列成多层结构,通过各层处理数据后,产生非线性输出。
要构建人工神经网络,程序员必须在整个训练过程开始之前先设计好架构。这种架构是固定的,在机器学习过程中不会发生变化,因此有时被称为“超参数”。然而,连接神经元的权重是可调整的或“可训练”的参数,这意味着它们可以在从数据中学习的过程中自主调整,而非预先编程设定。
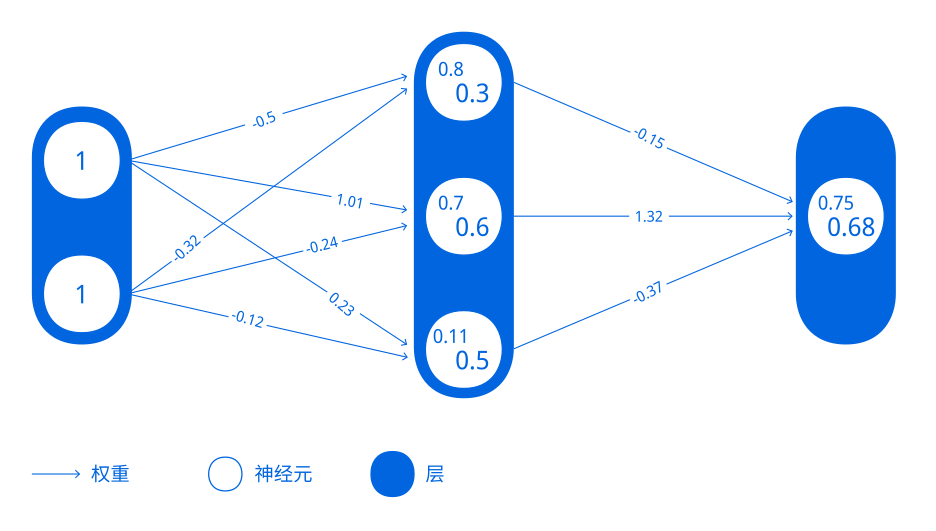 来源:Drexl, J.等人(2019年)。“Technical Aspects of Artificial Intelligence: An Understanding from an Intellectual Property Law Perspective”。
什么是生成式人工智能?
生成式人工智能(GenAI)指能够根据用户的提示词生成新内容的AI工具。提示词通常是对期望的输出所作的简短书面说明。新内容可以文本、计算机代码、图像、音频、录音和视频等形式呈现。
GenAI工具的广泛可用性对许多行业的知识产权都产生了重大影响,既带来了机遇,也伴随着风险。就知识产权而言,至关重要的是,GenAI模型不会自行启动:它们必须由人类以特定方式给出提示,才能生成输出内容。事实上,“提示工程”(即创建和优化输入指令,以促使GenAI模型更快地生成更优质输出内容的过程)已发展成为一项独立技能,需要对AI模型的能力和局限性有深入的理解。
什么是大型语言模型?
大型语言模型(LMM)是一种神经网络模型。大型语言模型为当今公开市场上可用的多款热门GenAI工具提供支撑。之所以这样命名,是因为这类模型非常适合处理和关联语言。大型语言模型能够开展各种自然语言处理任务,包括文本生成、语言翻译、文本总结等。
大型语言模型不仅限于处理人类语言。就机器学习而言,“语言”是指通过结构和关系来传达意思的任何符号(例如单词或代码)系统。正如人类语言的意义既源于词汇选择,也源于语法关系,编程语言也遵循类似的句法和上下文模式。这就是为什么有些大型语言模型能够生成Python或JavaScript等常见编程语言的计算机代码。为了有效地捕捉任何类型语言中的这些复杂关系,大型语言模型被设计为可处理序列、处理大型数据集并保留足够的上下文记忆。
ChatGPT由OpenAI于2022年11月推出,是一款大型语言模型聊天机器人,使人工智成为公众关注的焦点,并迅速转变了许多领域中人们的工作和创作方式。ChatGPT运用自然语言处理和深度机器学习,根据用户提示词生成书面内容。虽然它是首款获得主流广泛采用的此类产品,但Anthropic、谷歌和Meta等竞争对手不久后也发布了类似的聊天机器人。