
AI引发的主要知识产权问题有哪些?
AI系统的飞速发展以及AI工具的广泛可用性,给知识产权领域的一些最基本原则带来了诸多挑战。下文将对这些挑战进行概述。本指南后续章节将从企业关切的具体视角出发,对这些挑战进行更详细的探讨。
版权人与GenAI开发者
生成式人工智能(GenAI)模型需要海量的训练数据。例如,OpenAI最初的GPT-3模型是基于570千兆字节的文本数据进行训练的。在某些情况下,这些训练数据集的大部分内容是从互联网上抓取的,其中包含受版权保护的文本和图像。这引发了潜在的版权侵权问题。因此,对于平衡版权人的利益与GenAI开发者将版权作品用于训练模型的需求,主要存在两种相互冲突的观点。
GenAI模型的开发者有时会辩称,这些模型不会保存任何受版权保护作品的永久性复制件,只是临时访问材料中所包含的信息:这样一来,他们认为,使用受版权保护的训练数据集就像人类通过阅读书籍或欣赏艺术品来学习一样。当制作复制件时,无论是临时性的还是永久性的,开发者认为这些复制件属于现有的版权例外与限制,因此不构成侵权。
另一方面,许多版权人表示,未经授权将其作品作为训练数据集的一部分构成版权侵权。版权人已对AI开发者提起多起诉讼,但这些复杂的法律问题在短期内不太可能得到明确的答案。一个特别的争论点是,没有简单的方法来评估单个作品对训练AI模型的贡献程度,以及如何对版权人进行可能的补偿。此外,在许多司法管辖区,版权登记并非强制性要求,使得有时识别版权作品很困难。
GenAI输出的版权保护
GenAI能够生成种类繁多的创作性输出内容,包括文本、音频、视频和图像。对于这些AI生成的输出内容是否应受益于版权保护,国际社会目前正在就此展开讨论。
例如,美利坚合众国曾发生过一起备受瞩目的案件,涉及对名为《太空歌剧院》(Théâtre D'opéra Spatial)的作品申请版权保护,该作品几乎是完全使用AI图像生成器Midjourney创作而成的。该申请被驳回,理由是人类的创造性投入微乎其微。然而,在最近一起围绕作品《一块美国奶酪》(A Single Piece of American Cheese)展开的案件中,作者证明其在借助AI工具创作的同时,实施了充分的人为干预。美国版权局认定该作品符合登记要求。
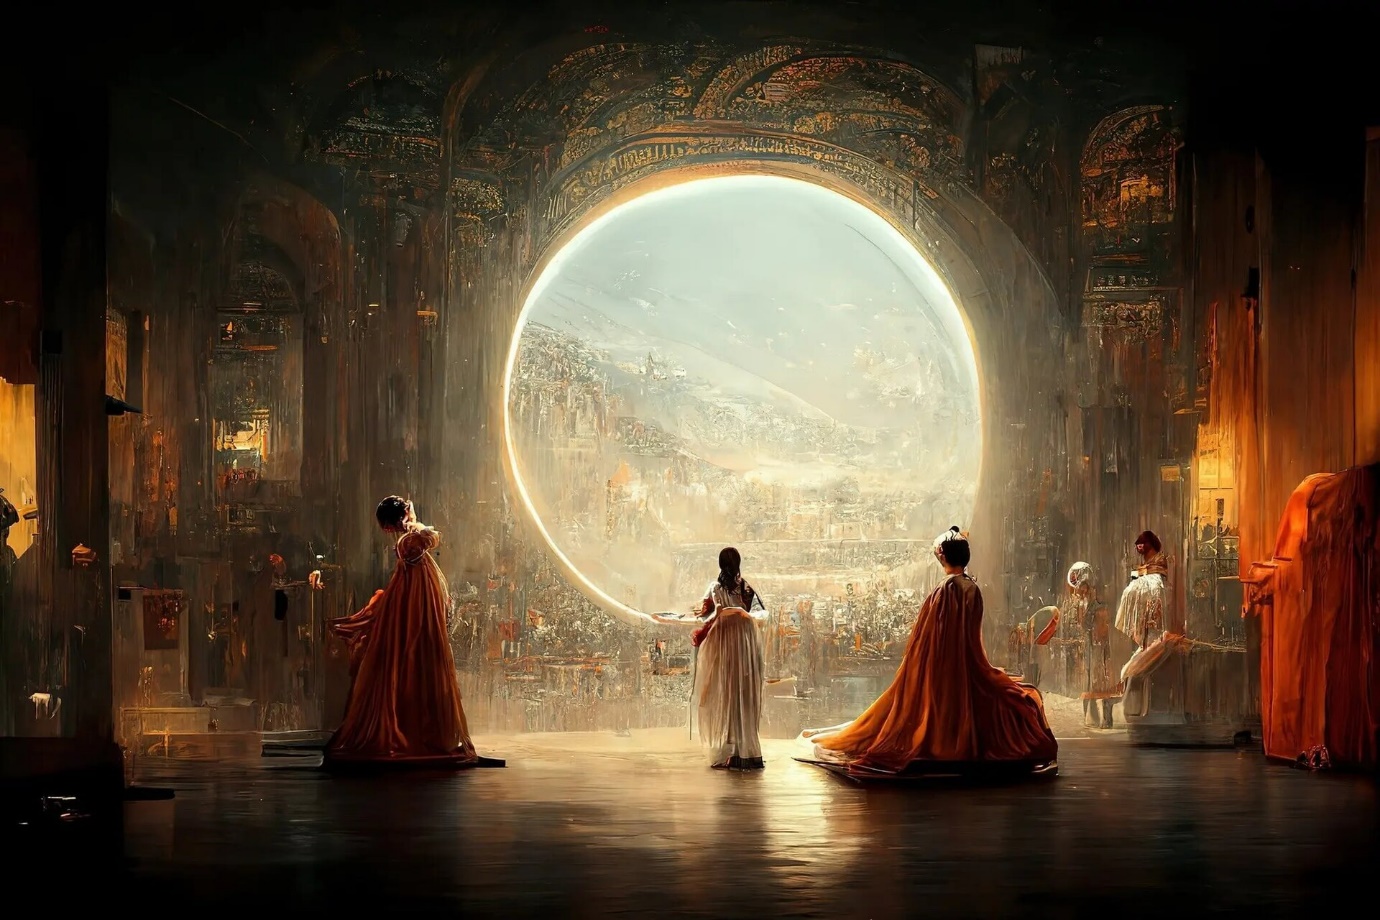 《太空歌剧院》是杰森·M·艾伦(Jason M. Allen)于2022年使用AI图像生成器Midjourney生成的作品。
2023年,北京互联网法院审理的一起具有里程碑意义的案件裁定,由Stable Diffusion(另一款AI图像生成器)生成的图像算作原创作品,因为创作该图像所需的人类提示词具备充分的人类创造力。该判决认为,GenAI可作为人类激发创造力的工具,如果人类创作者在将GenAI作为工具使用的同时,也做出了重大的创造性贡献,那么由此产生的作品有可能获得版权保护。如何衡量此类贡献并确定门槛,仍然是一个悬而未决的问题。
AI与发明人资格
AI系统能否拥有专利?能否将AI视为某项新技术或工具的发明者?
DABUS(“统一感知自主引导设备”)是由斯蒂芬·塞勒(Stephen Thaler)博士创建的AI系统,据称该系统在没有人类输入的情况下构思出了两项发明。塞勒针对这些发明在全球范围内提交了专利申请,并将DABUS列为发明人。大多数专利局以专利法要求列出人类发明人为由,驳回了以DABUS为发明人的申请。南非专利局因授予其专利成为了一个值得注意的例外,尽管该专利未经审查。除了这些法律上的驳回之外,许多计算机科学家仍然对当前的AI系统是否真正能够自主发明持怀疑态度。
什么属于人类的贡献?
尽管关于完全自主的AI发明这一概念仍存在争议,但政策制定者仍必须正视这样一个现实:AI在发明过程中正发挥着越来越重要的作用。这引发了一些关键问题,例如:
在发明过程中使用AI时,人类贡献应达到何种门槛,方可授予专利?
与单纯使用工具相比,什么样的人类贡献才属于发明过程的一部分?
AI模型的开发者和数据提供者,是否对利用其系统完成的发明所获得的专利享有权利?
每个问题都对创新激励措施、专利有效性以及专利制度的基本宗旨具有广泛的影响。
公开和透明度问题
专利法要求申请中必须列明发明人,并以足够详细的方式公开发明内容,以便他人能够复制该发明。然而,这些规定并不要求公开发明是如何完成的。这意味着,AI系统在发明过程中所发挥的作用可能不会被专利审查员和公众知晓。
如果各司法管辖区认定AI的参与程度对可专利性具有实质性影响,且如果人类贡献的门槛对授予专利具有重要作用,那么现行的公开框架便不充分。专利审查员在评估申请时,需要建立机制,以确定人类和AI系统各自的贡献。如果没有这种透明度,无论针对AI辅助发明制定出什么样的标准,都无法得到一致的适用,这将给专利申请人和审查员都带来不确定性。
如果现行知识产权法律保持不变,且专利法中关于人类贡献的门槛较高,那么AI生成的发明缺乏专利保护,是否会导致人们更加依赖商业秘密保护?这反过来可能会引发严重的透明度问题,并加剧AI“黑箱”问题。对AI的投资会因此受到抑制吗?如果某人被错误地列为AI生成发明的发明人,是否构成专利撤销的理由?
可能的政策解决方案
可能的政策解决方案包括:
探讨AI与人类的共同发明人资格
完全取消必须列明发明人的要求
将与该AI联系最紧密的人列为发明人
列明一位人类发明人,但要求公开AI的参与情况
建立针对AI生成发明的全新知识产权框架
无论结果如何,政策制定者都需要回归基本原则,分析专利制度的经济和社会目的,即通过授予发明人一定期限内利用其发明的专有权,来激励人类的创造力并促进新发明的公开。
目前知识产权和AI领域的主要立法及其他进展有哪些?
中国
中国在AI和知识产权领域采取了务实且日益宽松的做法,并通过针对特定行业的法规实施全面的AI治理。
2023年11月,北京互联网法院在一起具有里程碑意义的侵权诉讼案件中判定,AI生成的图像可获得版权保护,且根据中国版权法,输入提示词生成该AI图像者享有作者身份权。2025年3月,常熟市人民法院作出了类似的判决。法院认为,通过AI生成的图像可以被视为一项原创的智力成果,因为该过程涉及进行设计选择、编写提示词、设置参数以及选择最终输出结果。
 “春风送来了温柔”创作于2023年。在李某诉刘某一案中,存在争议的图片是由李昀锴使用AI图像生成器Stable Diffusion生成的。
2024年12月31日,中国国家知识产权局发布了《人工智能相关发明专利申请指引》。这些指引强调,专利文件中列出的发明人必须是自然人。2025年9月,《人工智能生成合成内容标识办法》正式生效,规定在中国境内在线传播的所有由人工智能生成的文本、图片、音频、视频、沉浸式虚拟场景,均须进行明确且嵌入式的标注。
欧洲联盟
欧洲联盟《人工智能法案》是一项全面的监管框架,已于2024年8月1日正式生效,并将采取分阶段实施的方式。该法案自2025年2月起禁止存在构成不可接受风险的AI系统,其中,行为准则将在该法案生效九个月后适用,而针对通用AI模型的规定则在12个月后适用。
《人工智能法案》中有两项条款涉及版权问题:第53条第1款(c)项和(d)项。第一项要求“通用人工智能”开发者遵守版权法以及《数字化单一市场版权及相关权指令》中规定的条件,允许进行文本和数据挖掘。从本质上讲,这意味着只要权利人未明确表示反对,受版权保护的材料即可用于训练AI模型。第二项条款要求AI开发者报告用于训练通用AI模型的数据集。这将产生透明度义务,可能揭露训练数据集中潜在的版权侵权问题。
2026年2月,欧洲议会法律事务委员会通过了一份涉及生成式人工智能与版权法交集的报告,表明其打算采取更强硬的立场,维护版权人的权益。
日本
日本是世界上第一个明确将文本和数据挖掘排除在版权责任范围之外的国家。值得注意的是,与其他国家的类似豁免不同,该豁免同时适用于商业用途和非商业用途。此举旨在促进日本数字经济的发展。自那时起,日本扩大了针对基于AI活动的豁免范围,新法律规定以下活动不构成版权侵权:
出于机器学习的目的对受版权保护作品的特定使用;
制作作品的附带电子复制件;以及
将受版权保护的作品用于数据核查。
日本在AI训练数据方面一直采取这种相对宽松的做法,但随着全球诉讼的增加,日本可能采取更加细化的立场。
联合王国
联合王国对“计算机生成作品”提供了保护,这是一种在联合王国、爱尔兰及少数其他司法管辖区特有的版权形式。简而言之,这些规则为完全由计算机创作、未涉及人类参与的作品提供了版权保护。该规则通过将生成作品的计算机系统的创建者列为版权受益人,从而解决了“归谁所有?”的问题。
乍看之下,这些法律似乎解决了AI生成作品的版权保护难题。然而,这种做法从根本上仍与全球各地的版权法——尤其是《伯尔尼公约》——相悖。这些版权法的设计基于这样一个核心假设:创作者是人类,且他们能从保护中受益。联合王国的做法违背了版权法“以作者为中心”的基本性质,因此对于AI作者身份这一挑战而言,这更像是一种有问题的权宜之计,而非妥善的解决方案。
2024年12月,联合王国政府发布了一份关于“版权与人工智能”的意见征询文件,其中除其他内容外,还提议改革对计算机生成作品的保护措施,这可能会对AI产生重大影响。经过上述意见征询,政府于2026年3月发布了《关于版权与人工智能的报告》。该报告未提出任何具体建议,放弃了此前的一些倾向(例如文本和数据挖掘例外以及权利人退出机制),总体上在该领域的政策制定方面采取了更为观望的态度。
《2025年英国数据(使用与访问)法案》并未立即要求AI开发者承担从权利人处获得同意的法律义务,但释放了强烈信号:可能很快出台针对AI与知识产权的正式监管框架。
美国
2025年2月,在汤森路透(Thomson Reuters)诉罗斯(ROSS)一案中,美国某联邦法院作出了2025年首例重大的AI版权判决,支持了原告的版权侵权指控,并驳回了被告的合理使用抗辩。 值得注意的是,本案中的AI工具并非创作新内容的GenAI模型,而是一种搜索引擎式的模型,其功能恰恰与其训练所基于的受版权保护材料构成直接竞争。自该案以来,美国其他判决(尤其是卡德雷(Kadrey)诉Meta和巴茨(Bartz)诉Anthropic)支持了合理使用抗辩。
2025年1月颁布的第14179号行政命令,通过撤销此前强调数据保护和透明度的指令,旨在消除那些被视为阻碍创新的联邦政策,从而重新调整了美国的AI政策方向。2025年12月颁布的一项后续命令旨在阻止各州执行各自的AI法规。
美国版权局就版权与人工智能发布了一份由三部分组成的报告。关于GenAI训练的第三部分内容于2025年5月以预发布版本形式发布,其基本结论是,目前制定相关立法为时尚早。相反,该报告建议继续根据具体情况适用合理使用原则,并在合理使用原则不适用时,以发放许可作为备用方案。
跨司法管辖区问题
当AI系统可能侵犯版权且案件进入法庭审理阶段时,会引发一些根植于国际私法的、具有挑战性的实际问题。这里的核心问题是:法院是否有审理此案的管辖权?
这是一个复杂的问题,不仅需要审视创建AI产品的公司错综复杂的企业结构(往往横跨若干司法管辖区),还需审视复杂的GenAI模型是在何处进行训练、优化和部署的(同样,往往也涉及若干司法管辖区)。
《欧盟人工智能法案》试图在序言第106条中解决这一问题。其中规定:
“通用AI模型的提供者应制定一项政策,以遵守欧盟关于版权及相关权的法律。”
该法案接着指出:
“任何将通用AI模型投放到欧盟市场的提供者,均应遵守此项义务,无论支撑这些通用AI模型训练的版权相关行为发生在哪个司法管辖区。”
简单来说:“如果你想在欧洲联盟销售你的AI模型,就必须遵守欧盟的版权法,无论该模型是在何处训练的。”其背后的逻辑是,任何公司都不应通过在版权保护较弱的国家对AI进行训练,从而在欧洲市场获得不公平的优势。
然而,尽管序言第106条内容很全面,但它并不具有法律约束力,且忽略了版权法受属地原则管辖这一事实。实际上,如果文本和数据挖掘活动在欧盟境外进行,且该模型仅在之后才投放到欧盟市场,那么其服务提供商将符合该序言的规定。相反,如果任何训练阶段(例如网络抓取)发生在欧盟境内,那么该序言将适用,服务提供商必须遵守欧盟法律。
尽管这些条款仅针对版权法和欧盟,但未来这种做法若被推广至知识产权法的其他领域以及欧盟以外的地区,也并不令人意外。其目标是避免出现“逐底竞争”心态,即AI公司为开发模型而选择监管最为宽松的司法管辖区,同时仍能进入更为严格的市场进行销售。